Volver al blog
Mejores herramientas de extracción de datos en 2026
Andrea López
Compartir
Las herramientas de extracción de datos en 2026 se han vuelto imprescindibles para las empresas que dependen de información precisa y en tiempo real para crecer. En un mundo en el que los datos alimentan todo, desde la generación de leads hasta el análisis de la competencia y la predicción de tendencias de mercado, estas herramientas permiten recopilar, limpiar y estructurar datos web de forma automática y a gran escala.
El reto para la mayoría de las empresas ya no es acceder a los datos, sino extraerlos de manera eficiente, sin perder tiempo ni arriesgarse a problemas de cumplimiento.
Las modernas herramientas de extracción de datos resuelven esto combinando IA, automatización e interfaces sin código, convirtiendo contenido web no estructurado en insights accionables listos para usar en CRMs, paneles de control o plataformas de análisis.
En esta guía explicaremos qué significa de verdad la extracción de datos en 2026, por qué se ha convertido en una capacidad tan estratégica para equipos B2B y de grandes empresas, y qué herramientas lideran el camino en velocidad, escalabilidad y automatización inteligente.
Entender la extracción de datos
¿Qué es la extracción de datos?
La extracción de datos es el proceso de obtener información de distintas fuentes para sacar conclusiones y tomar decisiones de negocio informadas. Esta información puede ser estructurada, no estructurada o parcialmente estructurada, según la fuente; una práctica esencial para las empresas cotizadas y las organizaciones que dependen de un acceso puntual y conforme a la normativa a los datos de negocio.
Por ejemplo, en ventas B2B, la extracción de datos puede consistir en sacar información de leads de redes sociales para crear una lista de prospectos segmentada. Sin embargo, una automatización excesiva o el scraping pueden provocar a veces restricciones en redes sociales, así que entender los límites de cada plataforma es clave antes de lanzar una extracción de datos a gran escala.
La extracción de datos es la primera fase del proceso ETL (Extract, Transform & Load). Las herramientas ETL toman datos en bruto de distintas fuentes y los preparan para integrarlos en otro sistema, asegurando que estén en el formato adecuado para analizarlos. Un ejemplo de herramienta que funciona de forma parecida a ETL es Captain Data, que realiza tareas como recopilar datos de múltiples fuentes web, agrupar datos en bruto en información estructurada e integrarlo sin fricciones en tu CRM u otras herramientas.
Por qué las empresas necesitan extracción de datos
Las empresas recurren a la extracción de datos por varias razones:
Crear bases de datos con información relevante y actualizada.
Generar insights accionables para estrategias de ventas y marketing.
Mejorar la calidad de los datos centrándose en fuentes relevantes y reduciendo los errores humanos.
Entender mejor el mercado y la competencia. Esto es especialmente cierto cuando se combina con señales de compra B2B, que ayudan a los equipos a entender la intención más allá de los datos en bruto — insights que a menudo revelan nuevas oportunidades de negocio para los equipos de ventas y marketing.
Cómo funciona la extracción de datos
Aunque el buscador de Google ofrece un ejemplo de extracción de datos al rastrear sitios web y extraer información para los resultados de búsqueda, este artículo se centra sobre todo en la extracción de datos estructurados, a menudo llamada “smart data”. Los datos estructurados están bien organizados y listos para analizarlos. El software de automatización, como Captain Data, utiliza técnicas de web scraping para recopilar estos smart data.
Web scraping o extracción de datos web
El web scraping consiste en extraer datos públicos disponibles en sitios web, lo que permite agrupar rápidamente información valiosa para introducirla en una base de datos. Entre los tipos de datos que se pueden extraer están los correos electrónicos, los números de teléfono y las direcciones postales. El web scraping se puede dividir en dos tipos: manual y automatizado.
El scraping manual consiste en copiar y pegar la información manualmente en una base de datos o una hoja de cálculo, y es adecuado para tareas de extracción de datos a pequeña escala.
El scraping automatizado, por su parte, utiliza herramientas de extracción de datos que sacan grandes volúmenes de información de fuentes online en muy poco tiempo.
El web scraping es especialmente valioso para los equipos de ventas, ya que les ayuda a:
Compilar listas de empresas objetivo y leads a partir de fuentes como Sales Navigator de LinkedIn, Google Maps, Páginas Amarillas y más.
Identificar a los principales responsables de decisión y posibles oportunidades de negocio.
Enriquecer y puntuar leads.
Ahorrar tiempo automatizando la introducción manual de datos y, al mismo tiempo, mejorar la precisión gracias a avanzadas herramientas de enriquecimiento de datos que complementan los flujos de extracción.
Presentamos las herramientas de extracción de datos
¿Qué hacen las herramientas de extracción de datos?
Las herramientas de extracción de datos usan la automatización para sacar datos de formularios, sitios web, correos electrónicos y otras fuentes online. Las herramientas de extracción de datos usan la automatización para sacar datos de formularios, sitios web, correos electrónicos y otras fuentes online, y a menudo sirven como base para el enriquecimiento de datos del CRM y la cualificación de leads.
Estas herramientas se dividen en varias categorías:
Soluciones SaaS
Extensiones de Chrome
Bots de scraping / APIs de web scraping
Bibliotecas de código abierto
Proxies y datasets
Las ventajas del software de extracción de datos
El software de extracción de datos ofrece numerosas ventajas, entre ellas:
Ahorro de tiempo: La automatización reduce el esfuerzo manual necesario en los procesos de datos.
Más eficiencia: Hacer más en menos tiempo.
Facilidad de uso: Las herramientas de extracción de datos sin código simplifican la puesta en marcha de flujos de automatización de datos, incluso para usuarios no técnicos.
Precisión: Reducir al mínimo el riesgo de error humano.
Escalabilidad: Acceder rápido a grandes volúmenes de datos estructurados para hacer crecer el negocio, como la generación de leads y las oportunidades de venta.
Ahora sí, vamos a ver las 10 mejores herramientas de extracción de datos.
Las 10 mejores herramientas de extracción de datos para 2026
1. Enginy
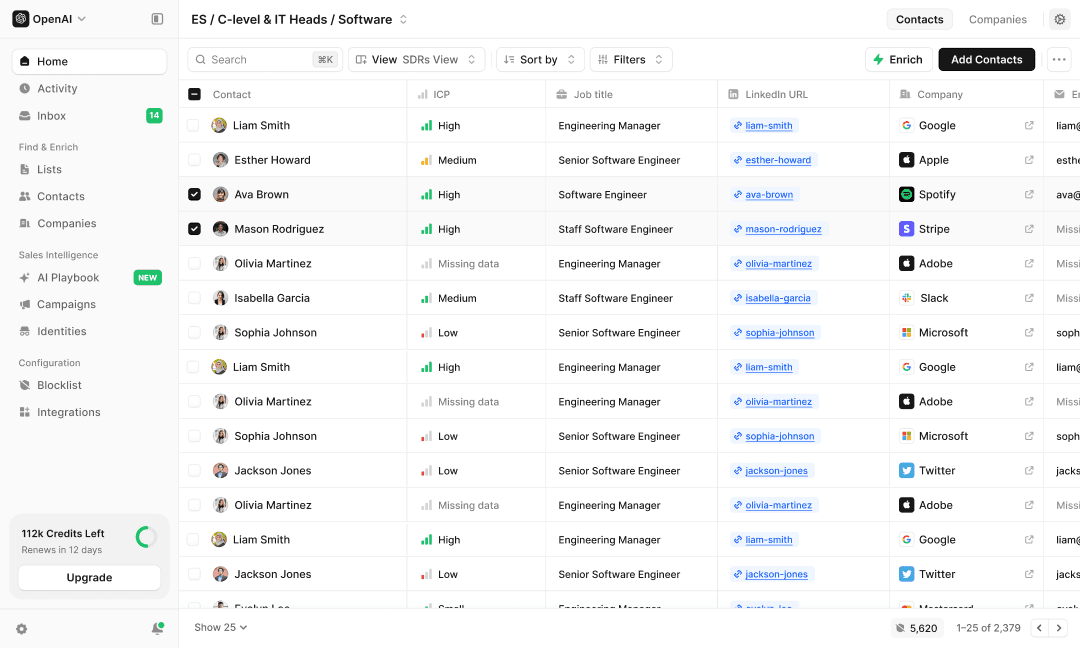
Enginy destaca como la plataforma definitiva de generación de leads B2B y automatización de outreach con IA, pensada para todo el mundo, desde responsables de ventas hasta usuarios sin perfil técnico. Esta herramienta fácil de usar simplifica la generación de leads al integrar agregación de datos B2B con automatización del contacto. Con Enginy, crear listas de leads a partir de redes sociales, enriquecer datos con correos y teléfonos verificados y lanzar campañas de outreach automáticas por email y redes sociales resulta muy sencillo. Enginy da prioridad a la facilidad de uso y a la estandarización, por lo que es accesible para todos, desde Sales Managers hasta Recruiters, ofreciendo resultados de forma simple y eficaz.
2. Phantom Buster
Phantom Buster es una potente herramienta de automatización de tareas online diseñada para simplificar y agilizar procesos repetitivos en la web. Ofrece una amplia gama de funciones de automatización, incluyendo scraping web para extracción de datos, automatización en redes sociales, interacciones masivas, automatización de tareas comerciales, acciones personalizables, integraciones y flexibilidad a través de distintas plantillas y configuraciones. Phantom Buster agiliza y simplifica las tareas online, ahorrando tiempo a los usuarios y mejorando la eficacia de las operaciones online.
3. Captain Data
Captain Data se gana el tercer puesto, ofreciendo una gran variedad de escenarios de extracción de datos y automatización. Facilita la extracción de datos estructurados de más de 30 fuentes, incluidas redes sociales, Google y TrustPilot. Más allá de ser una herramienta de web scraping, Captain Data es una suite completa de automatización de datos, con más de 400 flujos de trabajo listos para usar. Permite a los equipos de ventas y marketing trabajar de forma más eficiente y eficaz sin necesidad de programar. Captain Data es una solución ideal para equipos de Sales Ops y Growth que buscan escalar la generación de leads y acelerar el crecimiento de la empresa.
4. Octoparse
Octoparse es un servicio versátil de extracción de datos, adecuado para generación de leads, seguimiento de precios, marketing e investigación. Destaca por su facilidad de uso, ya que permite extraer datos con un sistema de apuntar y hacer clic, sin necesidad de saber programar. El rastreador web en la nube de Octoparse puede extraer datos de distintos sitios web y generar tablas de datos estructuradas. Los usuarios pueden programar y automatizar tareas 24/7 con flujos de trabajo de arrastrar y soltar. Octoparse extrae texto, enlaces, URL de imágenes y mucho más de toda la web. Ofrece un plan gratuito con hasta 10 crawlers, y el plan estándar parte de 75 $ al mes.
5. Diffbot
Diffbot está pensado para grandes empresas con necesidades específicas de rastreo de datos y screen scraping. Ofrece un conjunto de funciones para convertir datos web no estructurados en bases de datos estructuradas y contextuales. Diffbot sobresale extrayendo artículos, páginas de noticias, páginas de producto y foros. Los usuarios valoran sus APIs y sus recursos técnicos avanzados, especialmente para extraer datos de redes sociales. Sin embargo, algunos usuarios consideran que tiene una curva de aprendizaje y requiere familiaridad con su lenguaje de consulta. Diffbot ofrece una prueba gratuita de dos semanas con acceso completo a la API, y sus precios empiezan en 299 $.
6. Brightdata
Brightdata presta servicio a empresas de sectores muy diversos, como finanzas, retail, viajes y ciberseguridad, que quieren aprovechar los datos web en su beneficio. Brightdata Data Collector facilita la recopilación de datos web a gran escala sin necesidad de configurar infraestructura. Sus usos van desde la investigación de mercado y el SEO hasta el rastreo de buscadores y el seguimiento del mercado bursátil. Brightdata proporciona datos web estructurados compatibles con distintas aplicaciones. El precio de Data Collector empieza en 350 $ por 100.000 cargas de página.
7. Web Scraper (Extensión de Chrome)
La extensión Web Scraper para Chrome es una potente herramienta gratuita de extracción de datos que puede rastrear y analizar datos web. Aunque sea gratuita, ofrece capacidades muy sólidas. Los usuarios pueden extraer datos de sitios web dinámicos, incluidas categorías, subcategorías, páginas de producto y paginación. Web Scraper cuenta con una interfaz de apuntar y hacer clic y ofrece numerosos ejemplos para ayudar a los usuarios a empezar. Permite descargar rápidamente tablas y listas en formato CSV sin necesidad de programar. Aunque la extensión del navegador es gratuita, hay planes de pago para quienes busquen automatización, opciones de exportación adicionales, un proxy, parser y API. Los precios empiezan en 50 $ al mes para estas funciones.
8. Simplescraper
Simplescraper hace honor a su nombre ofreciendo web scraping simplificado. Esta herramienta es totalmente gratuita y se puede descargar al instante. Permite hacer scraping en local, ejecutar recetas en la nube o crear una API. Cada sitio web extraído se convierte en una API, lo que permite obtener datos actualizados una y otra vez. Simplescraper permite sacar datos de miles de páginas web con un solo clic, exportarlos a Google Sheets y extraer datos de enlaces con deep scraping. ¡Sorprendentemente potente para ser una herramienta gratuita!
9. Scraper API
Scraper API se adapta a empresas de todos los tamaños, desde startups hasta grandes corporaciones. Esta solución de extracción de datos gestiona proxies, navegadores y CAPTCHAs, lo que permite extraer cualquier página web con una simple llamada a la API. Los usuarios envían la URL de la que quieren sacar datos y Scraper API devuelve el contenido HTML. Ofrece geolocalización, bypass de anti-bots, renderizado JavaScript, soporte dedicado y proxies residenciales, lo que la convierte en una herramienta de scraping muy potente. Scraper API ofrece una prueba gratuita con 5.000 créditos de API, y los planes de pago empiezan en 29 $ por 250.000 créditos de API.
10. ScrapingBee
ScrapingBee demuestra ser una herramienta robusta de extracción de datos, adecuada para distintas tareas de web scraping. Los equipos de ventas la utilizan para generar leads, extraer información de contacto y sacar datos de redes sociales. Los profesionales del marketing recurren a ScrapingBee para growth hacking y tareas de SEO, como la supervisión de palabras clave y la comprobación de backlinks, gracias a su amplio pool de proxies. ScrapingBee gestiona instancias headless con la última versión de Chrome, ofrece renderizado JavaScript y rota proxies para minimizar el riesgo de bloqueos por parte de medidas anti-scraping. La herramienta ofrece una prueba gratuita con 1.000 llamadas a la API, sin necesidad de tarjeta de crédito, y un plan básico desde 49 $ al mes por 100.000 créditos de API.
Actualizaciones de enero de 2026 en la extracción de datos
La regulación está empujando la extracción hacia un acceso auditable
En enero de 2026, la extracción de datos en Europa está marcada por normas que premian el acceso a datos autorizado y trazable frente al scraping sin control. La EU Data Act se aplica desde septiembre de 2025 y, aunque no es una “ley de scraping”, refuerza un cambio más amplio: se espera que las empresas habiliten formas estructuradas de acceder a los datos y compartirlos generados por productos conectados y servicios relacionados.
Para los flujos B2B, esto reduce el atractivo a largo plazo de los pipelines de scraping frágiles y aumenta el valor de las pilas de extracción que pueden conectarse a APIs, exportaciones autorizadas y compartición de datos compatible con la gobernanza.
En paralelo, la EU AI Act ya está influyendo en cómo los proveedores construyen funciones de extracción con IA. Incluso antes de su plena aplicación en agosto de 2026, el mercado se mueve hacia expectativas más exigentes en torno al registro de actividad, la transparencia y los controles cuando se usa IA para enriquecimiento, clasificación o señales de intención.
El resultado, en la práctica, es más foco en trazas de auditoría, explicabilidad, políticas de retención y controles de usuario dentro de los productos de extracción.
Las defensas anti-bot se han convertido en una limitación clave del producto
2025 fue un punto de inflexión en la aplicación de medidas anti-scraping, y el impacto se ve con toda claridad en 2026. Las defensas modernas dependen menos de simples bloqueos de IP y más de la detección de comportamiento, el fingerprinting y los retos adaptativos.
Proveedores como Cloudflare han destacado públicamente nuevos enfoques para ralentizar o despistar a los bots, especialmente a los asociados con el rastreo automatizado a gran escala. Eso cambia los criterios de compra: las herramientas de extracción ya no impresionan porque “pueden extraer cualquier cosa”, sino que ganan valor cuando ofrecen rendimiento predecible, tasas de éxito estables y una gestión clara de fallos.
Para los equipos que trabajan con cargas reales, la nueva base es la madurez operativa: reintentos inteligentes, detección de bloqueos, estrategias de renderizado para páginas muy cargadas de JavaScript y observabilidad que muestre dónde y por qué falla la extracción. En otras palabras, las mejores configuraciones de extracción en 2026 se parecen menos a scrapers puntuales y más a canales de datos fiables.
Las fuentes first-party y basadas en consentimiento ganan prioridad
La incertidumbre en privacidad y tracking sigue remodelando las estrategias de captación. Con la presión continua sobre el seguimiento entre sitios y una apuesta clara por configuraciones que preservan la privacidad, muchas organizaciones están apostando más por datos first-party y consentidos.
Eso no elimina la extracción web, pero sí cambia el centro de gravedad: ahora aporta más valor extraer y estructurar datos de puntos de contacto propios como formularios, portales, analítica de producto, registros de eventos, marketplaces e interacciones con clientes, para luego enriquecerlos de forma controlada.
Esto también afecta a las herramientas. La extracción se combina cada vez más con validación de datos y resolución de identidad para que el resultado se pueda activar rápido sin ensuciar el CRM ni los análisis posteriores.
La métrica de éxito ha pasado del volumen a los registros útiles
En 2026, los equipos avanzados se fijan menos en el coste por mil filas y más en el coste por registro usable y enriquecido. Eso significa que la deduplicación, la verificación, las comprobaciones de frescura y las actualizaciones programadas ya no son “nice to have”, sino requisitos básicos.
Si un dataset no se puede activar rápido en un CRM, en una capa de analítica o en un flujo de outreach, se considera desperdicio operativo.
La conclusión práctica es sencilla: los programas de extracción más sólidos ahora optimizan para durabilidad, cumplimiento y velocidad de activación. La extracción de datos ya no es solo una capacidad técnica. Es una capa estratégica que conecta cumplimiento normativo, fiabilidad de la infraestructura y operaciones de ingresos de una forma que puede escalar sin romperse continuamente.
Actualizaciones de 2025 en las herramientas de extracción de datos
En 2025, las herramientas de extracción de datos han evolucionado muchísimo gracias a la integración de IA generativa, OCR avanzado y visión por ordenador. La prioridad ya no es solo leer PDFs o páginas web, sino entender documentos dinámicos y transformarlos en datos estructurados listos para integrarse con sistemas ERP, CRM o data warehouse. La tendencia es clara: más precisión, menos plantillas y una implantación más rápida.
1. Del OCR tradicional al procesamiento inteligente de documentos (IDP)
Las nuevas plataformas de Intelligent Document Processing usan modelos de IA preentrenados para extraer datos de facturas, contratos y albaranes, adaptándose automáticamente a los cambios de diseño.
Ahora alcanzan tasas de precisión superiores al 95%, frente al 60–80% del OCR tradicional, y se integran con flujos RPA para automatizar todo el proceso de extracción y validación.
2. Extracción web con IA y sin código
Las modernas herramientas de web scraping ya permiten extraer datos sin escribir código. Funciones como la rotación automática de proxies, la resolución de CAPTCHAs y la limpieza de HTML simplifican la recopilación de datos para equipos de marketing, analítica y e-commerce.
Esto hace que la extracción de datos sea más accesible y eficiente que nunca.
3. APIs listas para una integración fluida
La mayoría de las plataformas de extracción de datos ya incluyen APIs nativas que envían la información estructurada directamente a los sistemas destino.
Soluciones como Klippa, Procys y Airbyte convierten contenido no estructurado en datos listos para usar en minutos, reduciendo el tiempo de configuración manual y la complejidad.
4. Seguridad y cumplimiento reforzados
A medida que aumenta la extracción de datos sensibles, los proveedores están priorizando la seguridad de los datos y el cumplimiento normativo, cumpliendo estándares como GDPR, ISO 27001 y HIPAA — un área especialmente importante para los informes financieros y los sectores regulados.
Esto permite que la extracción automatizada se amplíe a finanzas, sanidad y seguros, donde la protección de datos es crítica.
5. Protecciones anti-scraping más potentes
Los sitios web están incorporando tecnologías anti-scraping avanzadas para frenar la recopilación de datos no autorizada.
Plataformas como Cloudflare y Reddit han implantado sistemas de detección y bloqueo, lo que empuja a las herramientas profesionales a añadir detección de bloqueos y enrutamiento adaptativo para mantener un rendimiento fiable en el scraping.
6. Entrada de grandes actores del mercado
Grandes empresas como Box han lanzado sus propias herramientas de extracción con IA, como Box Extract, capaces de procesar texto, imágenes e incluso audio.
Esto demuestra que la extracción de datos se ha convertido en una capacidad básica dentro de los ecosistemas de automatización empresarial y gestión de contenidos.
En conjunto, la extracción de datos en 2025 es más inteligente, más rápida y más compatible con la normativa — una función estratégica que ayuda a las empresas a agilizar sus operaciones y a tomar decisiones basadas en datos con confianza.
El futuro de la extracción de datos en 2025: de la automatización a la inteligencia
La extracción con IA se vuelve contextual
La era del web scraping simple ha terminado. En 2025, las herramientas de extracción de datos más avanzadas han pasado de capturar información en bruto a entender su contexto y relevancia.
Plataformas como Enginy, Diffbot y Captain Data combinan ahora modelos de IA, procesamiento de lenguaje natural (NLP) y machine learning para interpretar el significado de los datos que recogen.
En lugar de limitarse a extraer nombres de empresas o correos, estas herramientas detectan señales de intención, cambios organizativos y disparadores en tiempo real como rondas de financiación, cambios de liderazgo o tendencias de contratación.
Esta conciencia contextual transforma listas estáticas en datasets inteligentes y priorizados sobre los que los equipos de ventas y marketing pueden actuar de inmediato.
Por ejemplo, si un extractor con IA detecta que una empresa SaaS está contratando comerciales outbound y acaba de cerrar una ronda Serie A, etiqueta automáticamente ese registro como una oportunidad de alta conversión.
Esa combinación de enriquecimiento de datos y analítica predictiva permite tomar decisiones más rápido y hacer outreach con más precisión.
La nueva referencia ya no es cuántos datos puedes reunir, sino qué inteligentemente puedes utilizarlos.
Integrar la extracción en el stack de datos B2B
Uno de los mayores retos en las operaciones de datos es garantizar que la información extraída fluya sin problemas entre sistemas.
Las organizaciones B2B con mejores resultados ya tratan la extracción de datos como una capa central de su infraestructura de automatización, y no como una actividad aislada.
El stack de datos moderno tiene tres componentes esenciales:
Capa de captura: herramientas de extracción como Enginy o Brightdata recopilan datos estructurados y semiestructurados de fuentes públicas — sitios web de empresas, LinkedIn, directorios y páginas de reseñas.
Capa de enriquecimiento: esos datos en bruto se limpian, validan y amplían con información adicional — como la seniority del cargo, el tamaño de la empresa y señales de intención — antes de entrar en el CRM.
Capa de activación: los datos enriquecidos se sincronizan automáticamente con herramientas de outreach, permitiendo campañas multicanal por email, LinkedIn y otros canales.
Cuando estas capas funcionan juntas, los equipos consiguen un flujo continuo de información verificada y en tiempo real.
A este proceso, a menudo llamado orquestación de datos en vivo, se asegura de que tu CRM y tus paneles de analítica estén siempre actualizados y sean accionables.
El beneficio de la integración está claro: datos más limpios, mensajes más relevantes y menos tiempo perdido en actualizaciones manuales.
Cumplimiento y recopilación ética de datos
A medida que la automatización crece, también lo hace el escrutinio. El futuro de la extracción de datos depende también de la transparencia y el cumplimiento en materia de privacidad.
Los proveedores ahora hacen hincapié en la alineación con el GDPR, la certificación ISO 27001 y el origen responsable de los datos.
Plataformas como Enginy han incorporado el cumplimiento en su diseño: almacenan solo datos disponibles públicamente, anonimizan identificadores personales y mantienen trazas de auditoría para cada registro.
La extracción ética no solo evita riesgos; también genera confianza. En 2025, los clientes esperan responsabilidad en cómo se recopilan y usan los datos, y las empresas que lo priorizan consiguen una ventaja competitiva a largo plazo.
Maximizar el ROI y la escalabilidad en la extracción de datos
Calcular el retorno real de la automatización de datos
Las métricas tradicionales como el “coste por 1.000 registros” ya no bastan.
El verdadero indicador de rendimiento en los flujos de extracción modernos es el Coste por Registro Enriquecido (CER) — el precio que pagas por datos verificados y utilizables que realmente convierten.
Medidas así, las herramientas de extracción impulsadas por IA superan de forma constante a los scrapers manuales o de bajo coste. Aunque puedan costar un poco más al principio, su verificación, deduplicación y enriquecimiento integrados reducen de forma drástica el trabajo desperdiciado.
La conclusión: la opción más barata rara vez da el mejor valor. Cuando la automatización se combina con enriquecimiento con IA, precisión, velocidad y ROI mejoran al mismo tiempo.
Construir un flujo de trabajo de datos escalable y automatizado
Escalar la extracción de datos no va de añadir más herramientas, sino de diseñar un ecosistema conectado. Aquí tienes un marco práctico de tres pasos que usan los equipos B2B de mayor crecimiento:
Auditar y preparar: revisa tu CRM y elimina duplicados o registros obsoletos. Define qué significa “datos de calidad” para tu equipo — por ejemplo, correo verificado, cargo actual o tamaño de la empresa.
Automatizar la recopilación: configura extractores impulsados por IA como Enginy o Captain Data para sacar continuamente nueva información de fuentes online relevantes. Ajusta los flujos para actualizar campos clave (como cargos de contacto o firmografía) cada 30–45 días.
Activar y medir: conecta tus datos enriquecidos con plataformas de automatización como HubSpot, Apollo o LinkedIn Sales Navigator. Haz seguimiento de las tasas de reunión, el tiempo de respuesta y los ratios de conversión por cada 1.000 leads enriquecidos.
En 60 días, los equipos que siguen esta estructura suelen recortar la investigación manual en un 70% y ver un aumento de 2 a 3 veces en la eficiencia del outbound.
Tendencias futuras y lo que viene después
De cara al futuro, la extracción de datos seguirá fusionándose con la IA autónoma para ventas.
Agentes impulsados por herramientas como Enginy AI procesarán automáticamente los datos extraídos, iniciarán conversaciones y gestionarán seguimientos, cerrando el ciclo de los datos al diálogo.
También veremos innovaciones como:
APIs de enriquecimiento en tiempo real que introducen contactos verificados en los CRM al instante.
Crawlers autónomos que descubren nuevas fuentes sin intervención humana.
Modelos predictivos de extracción que anticipan qué leads tienen más probabilidades de convertir según patrones de interacción pasados.
La siguiente etapa está clara: la extracción de datos se convierte en extracción de inteligencia — un proceso continuo que alimenta la toma de decisiones, no solo las bases de datos.
En conclusión, las empresas que quieran aprovechar el poder de los datos tienen a su alcance una enorme variedad de herramientas de extracción de datos. Tanto si eres un profesional de datos con experiencia como si acabas de empezar en este mundo, estas herramientas ofrecen opciones muy distintas para cubrir tus necesidades y objetivos concretos. Explora las funciones y capacidades de cada una para ver cuál encaja mejor con los requisitos de extracción de datos de tu empresa en 2025.